用云端 AI 久了,有件事一直让我分神:额度。5 小时有一个上限,一周还有一个上限,干到一半提示用完,只能等。挺烦的。网络不好的时候也会卡住。还有一些问题,我不太想发到云端,但也没别的办法。
所以这次我在家里的 Mac mini 上把本地大模型认真跑了一遍。图的就两点:token 自由,想用多少用多少;免审查,少被拒绝。
前后测了三天。能用,而且能 7×24 小时开着。对话聊到 13 万 token,回一句还是 3–4 秒。云端额度用完了,它自动顶上。
下面是怎么配、不同设置差在哪,还有如果你也想买一台,内存该怎么选。
我的机器和用法
Mac mini,M5 Pro,20 核 GPU,64GB 内存,2TB 硬盘。它平时是家里的服务器,还跑着 AI 助手、影音库和视频生成,模型不能把内存全占了。所以我给模型进程设了 48GB 的上限,超了就停。
模型用的是 Qwen3.8-27B,一个 270 亿参数的模型。引擎试了 oMLX 和 MTPLX 两个,最后留下 oMLX。
跑起来到底多快
日常用的感受是这样:
| 场景 | 等多久 |
|---|---|
| 已经聊了 13 万 token,再问一句 | 3–4 秒开始回答 |
| 聊到 21 万 token | 4–7 秒 |
| 一次丢进去 1 万多字的新资料 | 几十秒到一分多钟 |
| 输出速度 | 每秒 20–27 个 token,短回答最快到 35.8 |
写这篇的时候,我又打开 oMLX 自带的网页对话测了一下。回一句“你好”,输出每秒 35.8 个 token,这是我见过最快的一次;让它写 300 字左右的介绍,每秒 25.9 个 token,从发出到写完一共 10.2 秒。
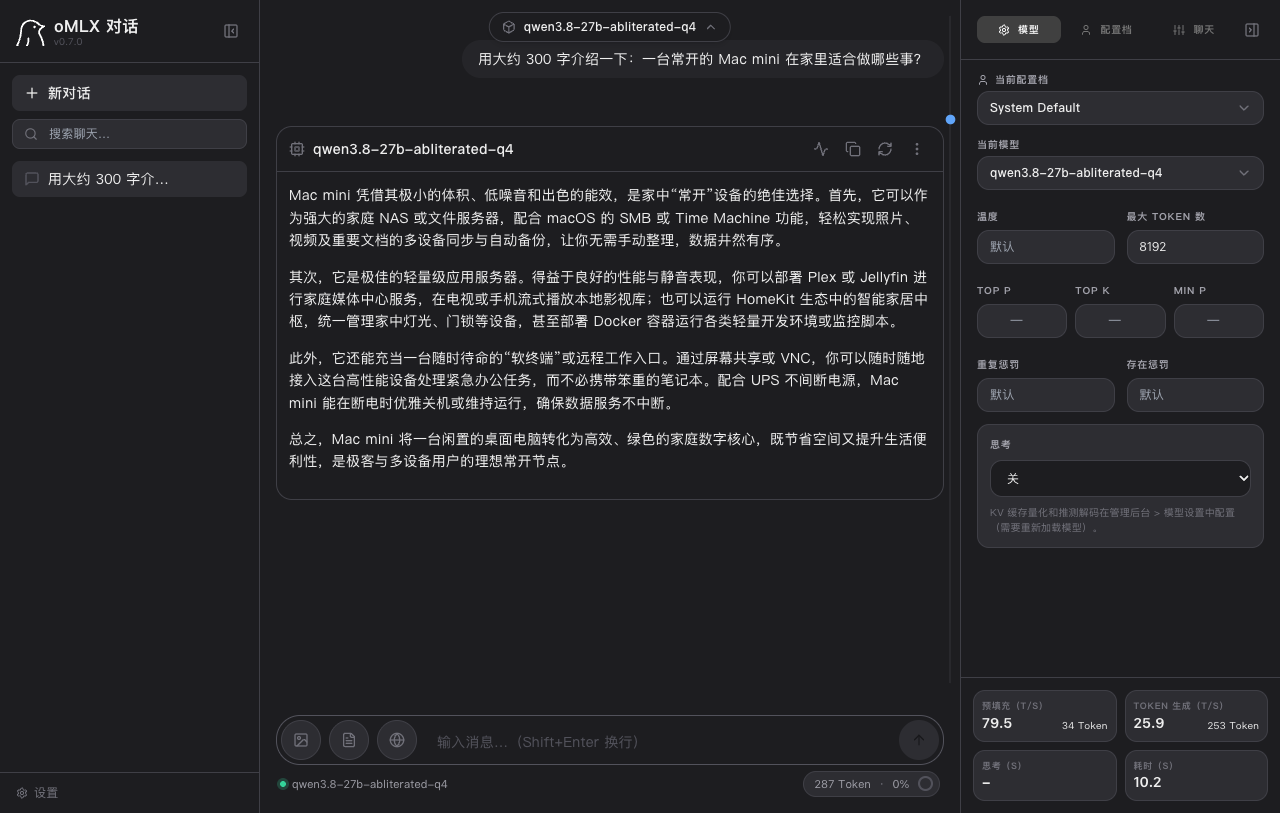
整个过程内存最高约 38GB,没有用到 swap。服务重启以后,之前的对话缓存还在,接着聊不用重新读。
这个速度能日常用。前提是开了一个设置:前缀缓存。
最关键的设置:前缀缓存
不开缓存的时候,你每问一句,模型都要把整段历史从头读一遍。聊到 6 万 token,每句要等 2–3 分钟。我第一轮测试测的是“一次读入 26 万 token 要多久”,结果是首字等了 18 分钟,差点得出“本地长对话没法用”的结论。
开了缓存,它只读新增的那部分。3–4 秒就是这么来的。
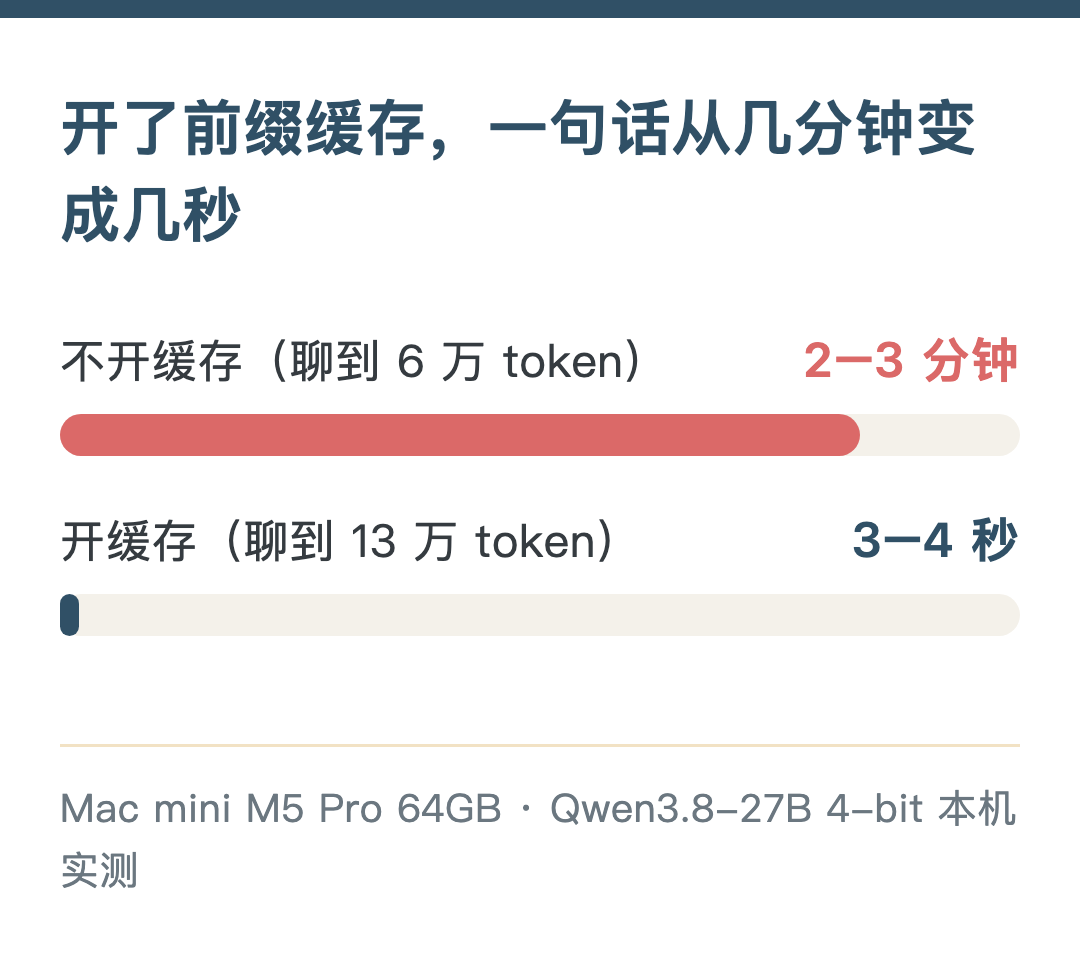
缓存比换量化、开加速都重要。这是我这次最大的收获。缓存我放在 SSD 上,上限 100GB,大约能存四五个聊满的长对话。
不同设置差在哪
4-bit 就够了
模型可以压成不同精度,位数越低越省内存。我拿 4-bit(Q4)和 8-bit(Q8)做了 63 道题的对比:
| 结构化题 | 代码 | 内存峰值(短对话) | |
|---|---|---|---|
| Q8 | 30/42 | 8/8 | 29.0GB |
| Q4 | 34/42 | 7/8 | 17.2GB |
Q4 不比 Q8 差。代码少对了一题,工具调用两边都是 3/3。一次读入 26 万 token 时,Q4 每秒读 237 个 token,峰值 36.1GB;Q8 每秒 160 个,峰值 45.4GB。oMLX 对 4-bit 有专门的加速,所以 Q4 又快又省。我又让 Q4 连续跑了两小时,13 道题全对,内存一直稳在 36GB。
免审查版:能力一样,收益没测出来
免审查版和官方版我都压成了 Q4,同一套题,得分几乎一样,速度也一样(每秒 16.61 和 16.70 个 token)。
但我准备的几道敏感题,两个版本都正常回答了,免审查到底多帮了多少,这次没测出来。按模型作者的说明,它是“减少拒答”,不是“完全不拒答”,开思考模式时仍有约 8.7% 会拒绝。
MoE 模型:快,但吃内存
还试了一个 35B 的 MoE 模型,它每次只用到 3B 参数,所以快:短对话每秒输出 56 个 token,是上面配置的 3–4 倍。但 8-bit 版光权重就占 35GB 左右,峰值到了 47GB,长对话不稳定。在 64GB 上,我把它淘汰了。
照着抄的配置
引擎用 oMLX 0.7.0,模型是 Qwen3.8-27B 免审查版 4-bit。下面这些,左边是设置,右边是在 oMLX 里怎么写:
| 项目 | 设置 | 在 oMLX 里 |
|---|---|---|
| 前缀缓存 | 开,放 SSD,上限 100GB | 启动参数 --paged-ssd-cache-dir、--paged-ssd-cache-max-size 100GB |
| MTP 加速 | 开 | 模型设置 mtp_enabled: true |
| 思考模式 | 关 | enable_thinking: false |
| 上下文窗口 | 160K | max_context_window: 163840 |
| 内存上限 | 48GB | 启动参数 --memory-guard-gb 48 |
| 同时处理 | 1 个请求 | 启动参数 --max-concurrent-requests 1 |
| 空闲卸载 | 30 分钟 | ttl_seconds: 1800,下次约 4 秒重新载入 |
两个要注意的地方:
MTP 要先导入。 这个 4-bit 模型的 MTP 权重放在单独的文件里,oMLX 默认读不到,要用 oMLX 自带的导入功能(import_mtplx_sidecar)整理一遍。它会直接改模型目录,先用 cp -cR 复制一份。值得折腾:聊到 13 万 token 时,输出从每秒 10.6 个 token 提到 26 个。
4-bit 有专门的读入加速(oQ A8),大约快 1.4 倍,我是开着的。Q6、Q8 用不上。
这几个我试过,不建议开:
- KV 缓存量化:读入和输出都慢了 2–3 倍。
- ANE 预填充:反而慢了 30%,还多吃 16GB 内存,而且会顶掉上面的 oQ A8。
- 内存热缓存:直接把内存撑爆。
- 256K 窗口:能跑完,但贴着 48GB 的上限,没有余量。
我还把它接进了 AI 助手 Hermes,当作备用模型:云端限流、额度用完或者断网时,自动切到本地。代价是每开一个新对话,第一句要多等 20 秒左右,因为助手每次都要带上一大段说明,大约 1.4 万 token。之后就快了。
从哪儿用它
同一个模型,我从四个地方用。oMLX 同时提供 OpenAI 和 Anthropic 两种格式的接口,所以常见的工具都能接上。快慢差别不在模型,在于每次请求要先读多少固定内容:
| 入口 | 新对话第一句 | 适合做什么 |
|---|---|---|
| oMLX 自带的网页对话 | 约 1.4 秒 | 纯聊天、写东西、不想上云的问题 |
| Hermes(在微信、飞书里用) | 约 20 秒 | 日常助手;云端不可用时自动切过来 |
| Claude Code | 约 35 秒 | 简单的编码,不想让代码离开机器时 |
| Codex | 约 54 秒 | 同上 |
同一个对话聊下去,各个入口都会命中缓存,差距就小了。不过说实话,27B 的 4-bit 模型做多文件的编码明显不如云端模型,我只拿它做简单的活。
笔记本上用也方便。我用 Tailscale 把它转到自己的设备上,只有我的设备能连,出门也能用。
能不能一直开着
能。但有几件事要知道。
耗电:推理的时候比空闲多耗 50–60W,峰值约 80W。模型闲着时几乎不额外耗电,30 分钟没用还会自动卸载。我平时大部分时间在打字,按每天累计推理一两个小时算,一年多用几十度电。
温度:芯片 1–2 分钟升到 75–77°C 后就不涨了,没有温控警告,也没降频。
硬盘:写入主要来自缓存,每 1000 token 新内容约写 140MB。很重度地用,一天约 28GB,一年 10TB 左右。主流 2TB 固态的标称写入寿命一般在几百 TB 以上,用十年问题不大。
不能和别的大任务一起跑:我这台还跑视频生成,峰值约 22GB,加上模型的 38GB 就超了,只能错开用。
如果你想买,内存怎么选
我只测了 64GB 这一台。下面除了 64GB,都是按实测的内存峰值推算的,只能当参考,买之前最好再看看同配置的实测。
| 内存 | 我的判断 |
|---|---|
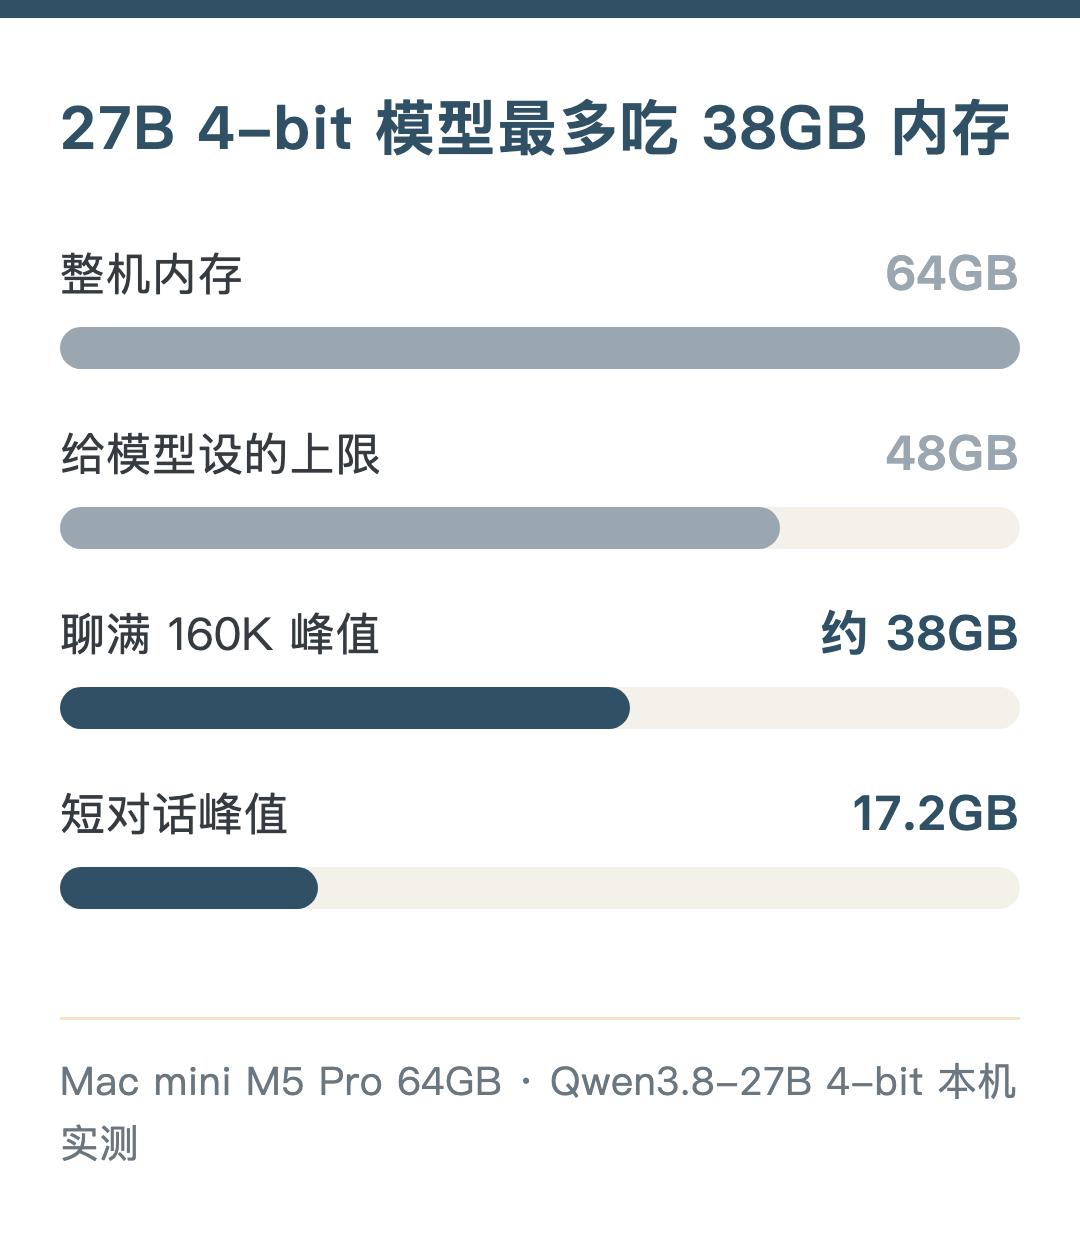
| 64GB | 实测:27B 4-bit、160K 长对话、同时跑其他服务都没问题,只是不能和视频生成这类大任务同时跑 |
| 48GB | 推测:27B 4-bit 能跑,短对话峰值只要 17GB;但长对话到 160K 时模型峰值约 38GB,再给系统留余量就紧了,上下文可能要收短 |
| 32GB | 推测:27B 4-bit 短对话可以试,长对话空间不多,也很难再同时跑别的服务;更现实的是换小一点的模型 |
| 24GB 及以下 | 推测:27B 这一档不太现实,建议直接选小模型 |
关于新出的 M6 Mac mini:苹果公布的配置最高 32GB 内存,所以按上面的推算,只能落在 32GB 这一档。新芯片快多少、引擎有没有为它优化,现在都没有实测,我不给结论。
我的取舍是:跑本地大模型,内存比芯片档位重要。芯片决定快慢,内存决定能不能跑、能聊多长。硬盘也别太小,缓存和模型都要占地方。
如果你主要用云端,偶尔想要个不限量、不出机器的备用,一台大内存的 Mac mini 现在已经能做到。希望这些数字对你选配置有帮助。
本文首发于微信公众号「像素李的AI笔记」,可在公众号内搜索阅读。博客版保留了文中的外链,和公众号版不同的地方都标了“博客版”。