如果准备买一台 Mac mini 跑本地 AI,内存选多少,估计是最纠结的地方。尤其是视频模型,光下载就上百 GB,很容易觉得机器也得配上百 GB 内存。
我在家里的 M5 Pro 64GB 上跑了一轮 MiniMax-H3。短片测试的内存峰值大多在 18.5–22GB,9 秒那次是 25.6GB;推荐参数生成约 2 秒的竖屏视频,要等 3 分钟左右。
所以,64GB 不是这次短片测试全部用得上的内存。但选配置也不能只照着 22GB 这个数买,系统、其他软件和 GPU 可用的内存还得一起算。下面把我实际跑过的结果列出来,给还没买机器的人一个参考。
用的是 Redis 作者 antirez 写的 h3.c,纯 C + Metal。文生视频、首尾帧和参考图都能用,还能一起生成声音。
先放两段生成效果:
(博客版:上面换成了带声音的原视频,公众号版放的是无声 GIF。)店员那段的“欢迎光临”说对了,不过也不是每次都这么顺利,下面说。
内存:64GB 用不满,小内存也不能直接照着买
Mac mini,M5 Pro,20 核 GPU,64GB 内存,2TB 硬盘。平时还跑着其他服务,测试的时候没停。你可能也想问:只是跑这个模型,需要买到 64GB 吗?
先看记录:
| 测试 | 记录的内存峰值 |
|---|---|
| 约 2 秒的短片,不同加速参数 | 18.5–22GB |
| 9 秒竖屏视频 | 25.6GB |
这些是生成过程记录的峰值,不是整台机器连系统和其他服务一起的总占用。这批测试没有用到 swap,64GB 确实有不少余量。在服务启动之前,余量在93%左右,跑服务的时候,余量仍可以保持在60%左右。
下载的模型体积和运行内存不是一个数。 h3.c 会分阶段加载不同部分;我这台 M5 跑的路径还会在加载时转成 int8。134GiB 的权重放在硬盘上,不代表同时要吃掉 134GiB 内存。
不过,还有个数要看:程序识别到这台机器的 GPU 推荐工作集是 51.8GiB。它表示 Metal 建议 GPU 同时使用的内存规模,不是模型已经占了 51.8GiB,也不是超过它就一定不能运行。Mac 用的是统一内存,但不能把包装上的 64GB 全当成 GPU 可以随意占满的空间。
这也是我没有直接写“24GB 就够”的原因。短片峰值已经在 18.5–22GB,9 秒那次到了 25.6GB;系统和后台程序还没算进去。换成小内存机器,原来这套参数还有没有余量,要重新验证。
如果现在让我为这套用法选内存,我会这样考虑:
| 内存配置 | 按这次测试怎么考虑 | 有没有实测 |
|---|---|---|
| 24GB | 短片峰值已接近整机内存,9 秒那次超过它;不能照搬这套参数,得另测省内存方案 | 没有 |
| 48GB | 比这批峰值有更多余量,主要做短镜头、同时运行的程序不多,值得考虑 | 没有,是根据本机记录推测 |
| 64GB | 我还常驻其他服务,这批测试没有用到 swap,用起来比较省心 | 有,就是本文这台 |
原报告里对 48GB 的估算,是假设 GPU 工作集约为内存的八成,大约有 38GB。这个比例只是估算,不能当成每台机器固定的配额;买到其他配置,仍要看程序实际识别的数。我也没有把 48GB 跑过一遍,所以这里说的是“值得考虑”,不是保证它和 64GB 一样快。
小内存还有一条路,但要用时间换空间。 h3.c 的 --ssd-streaming 会一边计算,一边从 SSD 读取主模型的后续部分。作者在 M5 Max 上记录的主模型张量存储降到了约 2.0–2.1GiB;注意,这不是整个程序只用 2GB,文本编码、视频解码、系统和其他缓冲区仍然要内存。
作者的测试里,两种画幅的一轮主模型计算分别慢了 26% 和 84%,比较的是同一套 BF16 路径。它不能直接换算成“24GB 的 Mac mini 总共要等几分钟”,也不能套到我这里的 int8 测试上。这次我没有测流式加载,所以先不给这个答案。
所以,64GB 的价值在于留余量,不能仅凭这几段短片说它是刚需。如果主要跑 H3 短镜头,我会先考虑 48GB;如果还想同时跑其他模型和服务,就更愿意留到 64GB。24GB 得先验证省内存方案,再决定能不能接受它的速度。
那现在讨论很多的 M6 Mac mini 呢? 苹果公布的配置最高是 32GB 统一内存,选不了前面说的 48GB 或 64GB。对照这次 18.5–22GB 的短片峰值,32GB 看起来有尝试的空间;但 9 秒已经到 25.6GB,还要给系统和其他程序留位置,不能只看“32 比 25.6 大”就判断一定能跑。有 m6 的小伙伴,欢迎在评论区留下你的测试结果。
还有软件适配这件事。截至这篇更新时,h3.c 的公开说明仍主要围绕 M3 Max、M5 Max 做优化,尚未列出 M6 的专门优化和实测结果。我这里用的也是针对 M5 的加速路径,不能因为 M6 更新,就把本机约三分钟的成绩直接套过去。
所以,如果主要为了 H3 买 M6,我会先等它的适配情况和同配置实测;如果还要做别的事,H3 只是偶尔玩玩,那可以继续把它放在候选里。我没有 M6,暂时不给它编一个预计耗时。
内存放得下之后,接下来才是每天用不用得下去:生成一段视频,要等多久?
生成速度:短镜头够用,长片要等
下面都是这台机器的实际记录,竖屏 576×1024,推荐画质:
| 请求时长 | 总耗时 |
|---|---|
| 2 秒 | 2 分 40 秒 |
| 3 秒 | 3 分 35 秒 |
| 5 秒 | 7 分 24 秒 |
| 9 秒 | 17 分 20 秒 |
程序会把帧数往上凑,所以实际视频会比请求的时长略长。时间从开始跑算到输出文件,加载模型、生成和解码都算进去了。
2 秒和 3 秒的可以接受,做一个短镜头够用。再往上,等的时间就长了。我最初用两个数据点估算,觉得 9 秒大概要 12 分钟,结果跑了 17 分钟。15 秒没测,平时也用不到那么长的。
本文用的 h3.c 版本是 8974cc0,测试时间是 9 月底到 10 月上旬。
推荐档和草稿档
同一张图、同一个提示词和种子,我测了几种加速方法。一段 2.33 秒的竖屏视频:
- 默认参数:433 秒。
--layers 45 --core-reuse 4:188 秒。- 内部尺寸降到 288×512,再用上一组参数:59 秒。
第二组和默认那组,原尺寸裁脸对比几乎看不出区别,所以我把它定成了推荐档。
第三组细节明显发软,但构图和动作基本没变,可以先看方向对不对。草稿一分钟一版,满意再用推荐档重跑。
这个“一分钟”和“看不出区别”都是这组素材的结果,换素材还是得自己看。
如果先用草稿试方向,满意后才重跑推荐档,就不用每次都等三分钟。不过,省下内存和等待时间之后,还有一笔不能漏掉:硬盘。
硬盘也得算进去
Hugging Face 上整个仓库有 464GiB,但事实上不需要完全下载到本地。h3.c 用不到根目录的那套权重。
文生视频和首尾帧需要 FL2VA,134GiB;参考图需要 Ref2VA,也是 134GiB。我后来对了一下文件,发现两边的文本编码器、VAE 等文件完全一样,只有视频主模型不同。用 APFS 克隆复用相同文件,再下 62GiB 就够了。
文生和参考图两套都要的话,按这次的复用方式,模型本身约占 196GiB。这个数还没算系统、软件、输入素材和生成文件。只跑文生视频可以先下 134GiB 那套,不需要一开始就把所有功能装齐。
国内下载可以用 ModelScope 上 MiniMax 官方的同名仓库,我这边实测 73MB/s,134GiB 半小时下完。
机器能跑,效果又是另一回事。前面的 GIF 是成功的结果,下面这几次失败更能说明实际用起来要注意什么。
台词要按格式写
第一次写提示词,我把台词混在一段描述里,结果人物说出来的是含糊的、像日语又不是日语的音节。
后来照着格式,把台词单独放进去:
1
<d>[Chinese] 欢迎光临!</d>
再标上说话人 (S1),这才正常。
我还专门对比了程序直接拼提示词和让 AI 扩写。面包店这个场景里,程序拼的也能说对,描述用中文、英文都行。AI 写了一大段,反而在开头多了一行字幕。所以现在默认直接由程序组装,需要更细的镜头描述才开 AI 扩写。
真人也试了一下,“国庆快乐”说成了“国供快乐”。动画店员那段没问题,不代表真人台词也稳,这个还得继续测。
参考图模式
如果你用过 minimax h3,就知道它有3种模式:文生视频、图生视频、首尾帧视频。
文生视频和首尾帧大家都理解;但图生视频需要的是参考图。而参考图要怎么给,描述要怎么写,还是需要一些技巧的。
我给了人物图和雪地松林,想让女孩走进树林介绍环境。素材是这几张:
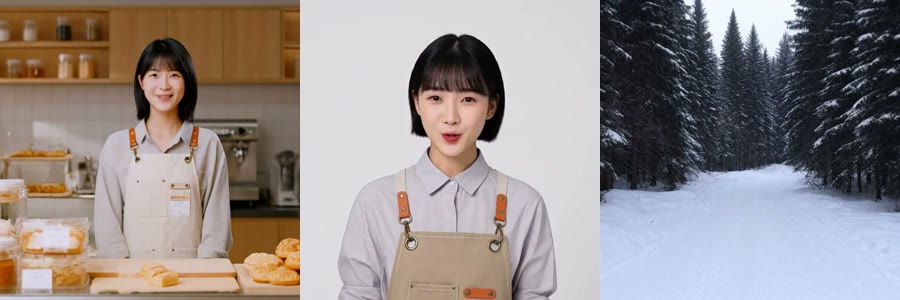
结果有时开头还是面包店,有时全程都是人物图里的纯色背景,松林根本没用上。
后来加了一句:人物图只取人物,背景不出现。同样四组组合,不加这句有两次失败,加上之后四次都对了。
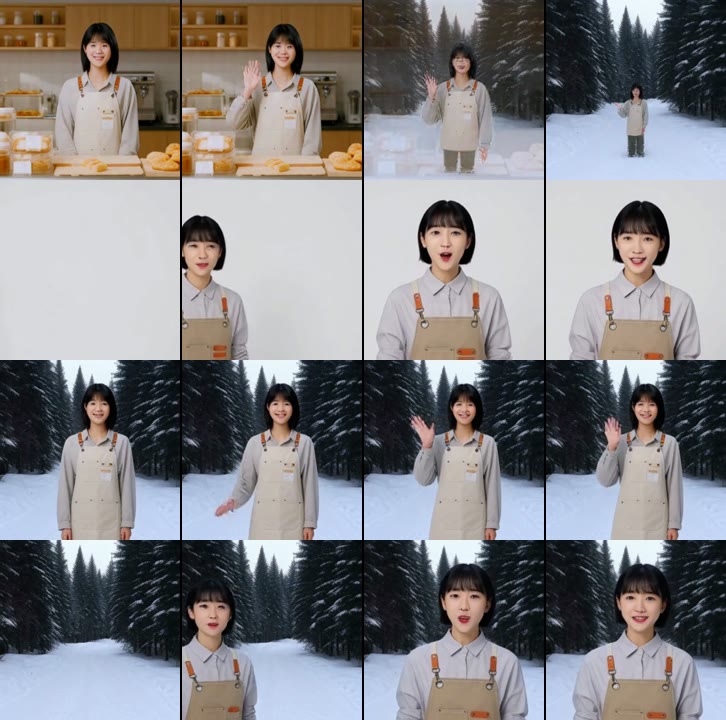
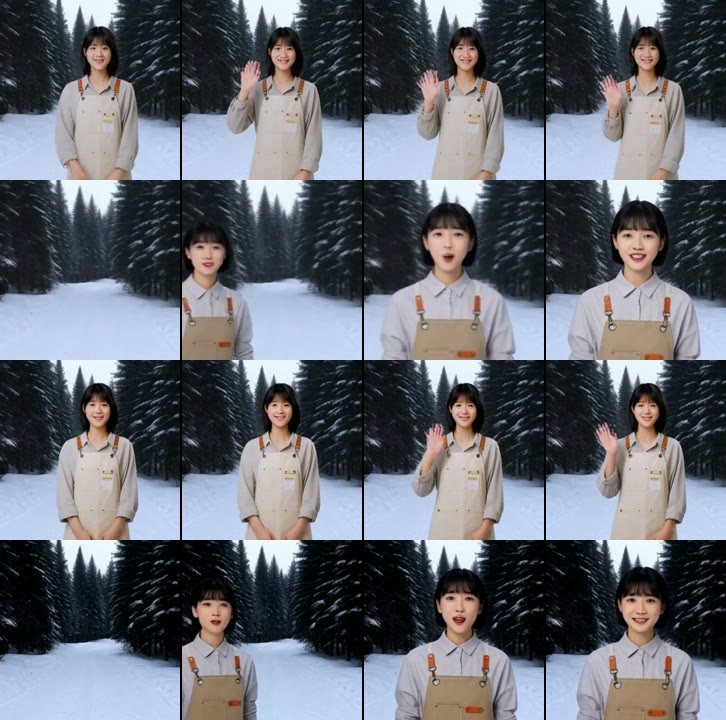
动作也一样。“慢慢走进树林,介绍环境”,测了 6 次都没得到画面和台词一起正确的结果。改成“从左边走进来,停下来,介绍这个地方”,4 次都对了。
每张图是什么,也要写清楚。我这组测试用具体的英文名词加一句特征比较稳,中文定义和笼统的 person、place 都不太行。
这些测试用的是同一套素材、两个种子,每种写法就试了几次,别把这里的成功率当成保证。要自己试的话,人物图尽量用干净背景,场景图里也别放抢眼的人或动物,先出草稿看效果。
自制 WebUI 已开源
我把它包成了一个服务,网页、命令行、微信和飞书对话共用一个任务队列。
网页里填描述、台词,选画幅和画质就能提交。参考图每张填用途、它是什么、有什么特征,程序会拼好格式。有场景图时,就自动加上前面那句“其他图只取主体,不要背景”。
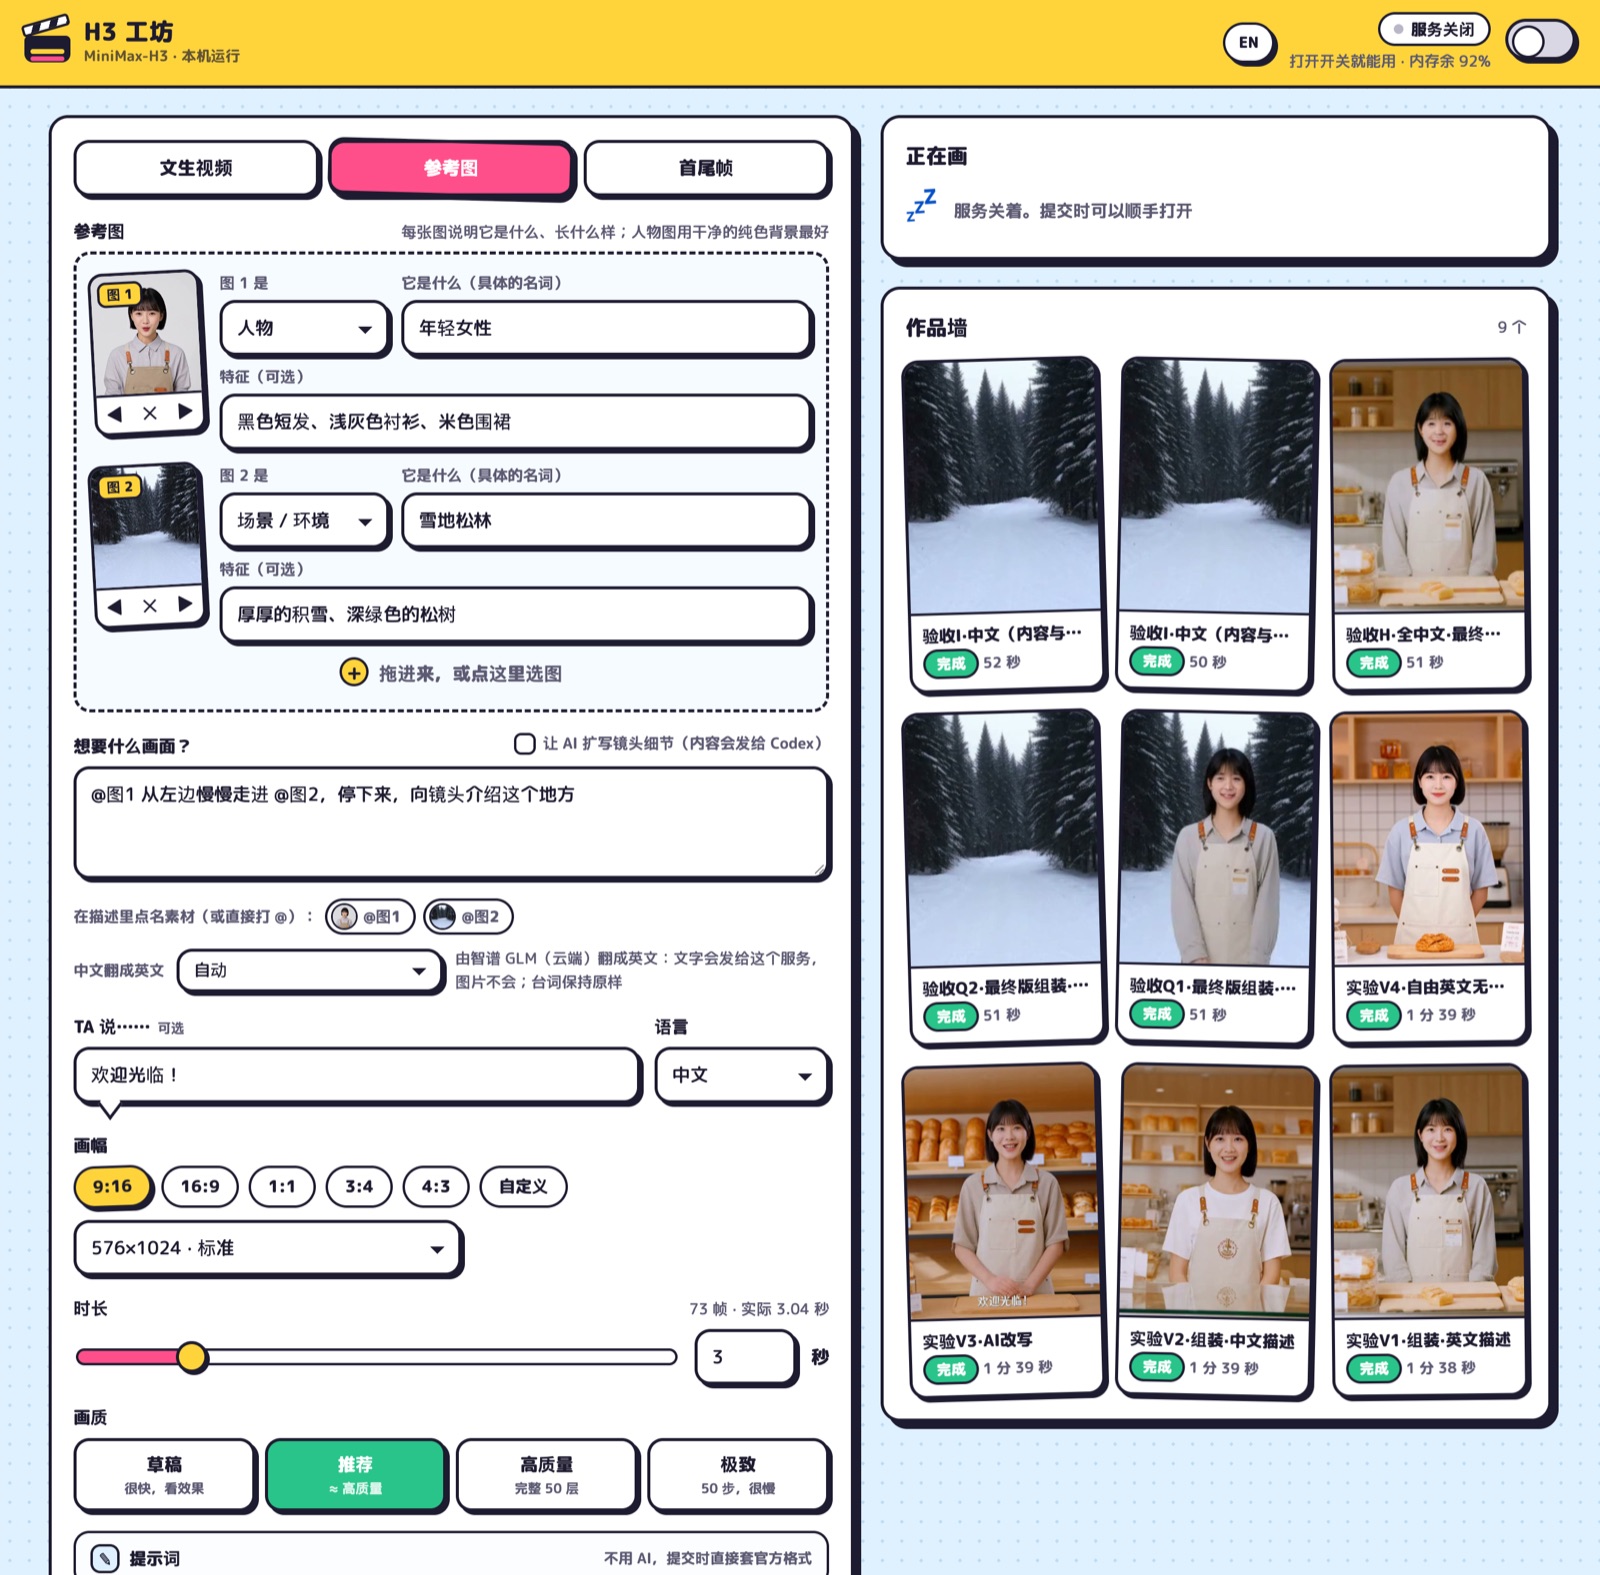
现在在对话里说“图里的女孩挥手说欢迎光临,3 秒”,附上图,生成完就能收到视频。空闲一小时会自动关服务。
这套网页和队列整理后开源了,叫 h3-studio (求星星):
https://github.com/shisaq/h3-studio 翻译、AI 扩写、聊天推送都是可选插件。视频生成在本机跑;选了云端翻译或 Codex 扩写,对应的文字、图片还是会发出去。想全程本地就选本机翻译,不开扩写。
目前我会继续用它做 2–5 秒的短镜头,让插画动起来,或者先试试一个想法。长视频等得久,台词也没稳定到可以不检查。
如果你还没买 Mac mini,可以先对照这些结果想想自己的用途:主要生成两三秒素材,还是要经常出长视频;只跑 H3,还是同时跑别的模型和服务。前者对我来说已经能用,后者要把等待时间和资源余量多算一些。
我测的是 M5 Pro 64GB,不能把这里的速度直接套到其他芯片或内存配置上。这篇能提供的是这台机器实际做出来的东西、占用和耗时。买的时候除了内存,也别漏掉硬盘:模型下载不小,生成的视频也会继续占硬盘。
总结
本地模型肯定没有云端模型能力强,minimax当然也不例外,跟即梦这样的模型没法比。而且为了跑本地模型,一台丐版的 Mac mini 肯定也是不够的。但它胜在2方面:1,再也不用为了积分或者token消耗而担心;2,隐私性强。
本文只是我自己的测试和分享,希望能给你带来一些参考价值。欢迎大家在下方留言讨论。
本文首发于微信公众号「像素李的AI笔记」:原文链接。博客版保留了文中的外链,和公众号版不同的地方都标了“博客版”。