这是一份给自己看的完整记录:以后再训练新的声音、或者在新对话里接着改,先读这篇。代码都在 qwen3-tts-console(网页在根目录,训练流程在
finetune/)。文中两个被训练的人称为说话人 A、B。
结论速览
| 项目 | 数值 |
|---|---|
| 机器 | Mac mini,M5 Pro,64GB;GPU 最多能用 51.8GB(81%) |
| 起因 | 10 秒参考音频的零样本复刻,音色和口音不像本人 |
| 素材 | A:6 段视频约 24 分钟 + 1 段 23 分钟对话;B:13 段视频约 42 分钟 + 同一段对话 |
| 自动处理 | 约 90 分钟素材,十几分钟切完、转写完、筛完人 |
| 人工复核后 | A 165 段 / 18.0 分钟;B 361 段 / 38.9 分钟(复核用时约 1.5 小时) |
| 训练(1.7B,10 轮) | A 17 分钟,B 37 分钟,内存峰值约 39–41GB |
| 声纹相似度 | A:0.72 → 0.84;B:0.57 → 0.82(零样本 → 最好的一轮) |
| 错字率 | 所有版本都低于 1% |
| 上线 | A 用第 8 轮,B 用第 10 轮;生成 5 秒语音约 2 秒,加载 0.5 秒,每个模型约 3GB |
| 低内存 | 0.6B 冻结 20 层:峰值 10.6GB,相似度 0.83,推算 16GB 机器能跑 |
整体结构
1
2
3
4
5
6
7
8
视频 ─(先自己提取音频)─▶ wav
  ─ prep_data.py   FunASR 转写 + 切 2–10 秒 + CAM++ 筛人      (.venv:torch + funasr)
  ─ review.py      网页复核:听、改字、保留/丢弃              (同上)
  ─ build_train.py Qwen3-TTS-Tokenizer-12Hz 编码成语音 token  (.venv-train:qwen-tts + torch)
  ─ sft.py         在 Base 模型上微调,存成 custom_voice 检查点(同上,MPS)
  ─ gen_samples.py 每一轮转成 MLX 8bit,和零样本一起生成样音   (网页的 venv:mlx-audio)
  ─ score_samples.py 相似度、错字率、语速;对比页靠耳朵挑       (.venv)
  ─ ttsd 的 tuned_voices 配置 ─▶ 网页“我的音色”里出现
3 个 Python 环境是故意分开的:FunASR、qwen-tts、mlx-audio 各自钉了不同版本的依赖,混在一起容易打架。测试过的版本:funasr 1.4.16、modelscope 1.40.2、qwen-tts 0.1.1、torch 2.14.1;mlx-audio 用网页 requirements.txt 里钉的提交。
网页本身(ttsd)是一个 Python 单文件服务,用 launchd 常驻、Caddy 反代,模型用 mlx-audio 跑 8bit 量化版,空闲 10 分钟自动卸载。
数据准备
转写:FunASR,不是 Whisper
AutoModel(model="paraformer-zh", vad_model="fsmn-vad", punc_model="ct-punc", spk_model="cam++"):
- Paraformer-zh:中文识别准,给每个字的时间戳。1.8 分钟音频转写 12 秒。英文单词经常拼错(Gartner → garten),以英文为主的片段直接丢弃(字母数多于汉字)。
- fsmn-vad / ct-punc:断句和加标点。
- CAM++:声纹。实测同一个人的片段 0.72–0.75,不同人 0.08–0.36,两个人的参考录音之间 0.31。阈值:≥ 0.55 保留,0.45–0.55 待定,更低丢弃。主持人、插话、对话里的另一方都靠它去掉。
一个 FunASR 1.4.16 的 bug:sentence_info 把每个标点放晚一个字(“开发者。大家好,很高兴”变成“开发者大。家好很,高兴”),按它切片段会在词中间断开。完整文本 text 和逐字时间戳 timestamp 是对的,所以自己重切:按 [A-Za-z']+|标点|单个汉字 分词,词数和时间戳数一一对应(实测完全对得上),遇到标点断句,说话人标签取时间上重叠最多的 sentence_info 段。
切片规则
- 同一说话人、间隔 ≤ 0.5 秒的句子合并成 2–10 秒的片段;够 4 秒且遇到句号就提前断开。
- 前后各留 0.08 / 0.15 秒,但不越过相邻句子的中点。
- 有声部分响度统一到 -20 dBFS,峰值不超过 -1 dBFS。
- 噪声底取整段音频 50ms 帧能量的 10% 分位,下限 -90 dB(合成或降噪过的音频会出现数字静音,不设下限信噪比会显示成 150 多)。
- 同一事件的两个剪辑版本会有重复句子:文本相似度 > 0.8 且来自不同文件的,保留信噪比高的那段。
- 自动标记:英文、语气词(呃嗯额)、重复/口误、连串中文数字,复核时优先看。
- 英文术语统一大小写(ai → AI、gpt → GPT),产品名的误识别放进配置的
terms。
人工复核
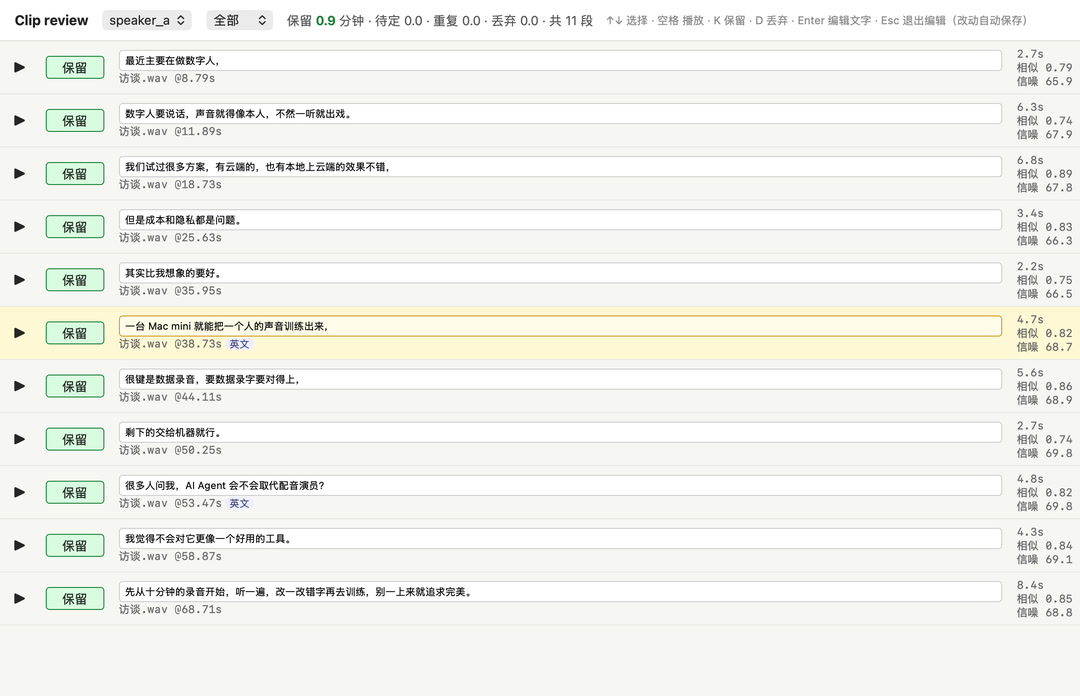
改动写进 edits.json(按片段 id),重跑数据准备不会丢。A 的 198 段里改了 55 段文字(29 段错别字、19 段英文词、7 段只动标点),丢掉 33 段。B 的 469 段改了 109 段、丢掉 108 段,用时约 1.5 小时。我的感受是自动识别已经很准,只有少数断句不对。
训练脚本:官方 sft_12hz.py 的 4 处问题
先用没训练过的 Base 模型在真实片段上算损失:设置正确时损失应该很低,因为预训练模型本来就能预测真实语音。第一次冒烟测试损失 7.5,接近瞎猜(词表 3072,均匀分布约 8.0),才去对照推理代码排查:
| 设置 | talker 初始损失 | 子模型初始损失 |
|---|---|---|
| 官方脚本 | 11.9 | 9.1 |
| 标签只错位一次 | 7.9 | – |
再加 text_projection |
1.2 | – |
| 子模型用上一帧隐藏状态、损失不再错位 | – | 5.4 |
- 标签错位两次(QwenLM/Qwen3-TTS#179):talker 的 HF 损失内部会错位一次,脚本又手动
[:, 1:]。模型学成预测隔一帧的 token,症状是越训语速越快。改法:输入和标签都不切片,让损失函数自己错位。 - 漏了
text_projection:推理时所有文字向量(角色标记、tts_pad/bos/eos、正文)都先过talker.text_projection,训练脚本直接用了text_embedding的输出。维度都是 2048,不报错,模型一直在学推理时见不到的输入。 - 子模型也错位两次:
forward_sub_talker_finetune返回的 logits 已经和codec_ids[:, 1:]对齐,内置损失又错一位;而且推理时 code predictor 拿到的是“预测出这一帧的那个位置”(t−1)的隐藏状态。改法:hidden[:, :-1][codec_mask[:, 1:]]配codec_ids[:, 1:][codec_mask[:, 1:]],自己算不错位的交叉熵。 - bf16 存权重:学习率 2e-6 时,AdamW 每步的更新量小于 bf16 能表示的精度,大部分被舍入掉。改成 fp32 存权重、bf16 autocast 计算。
其他设置:学习率 2e-6,5% 预热 + 余弦衰减,batch 2 × 梯度累积 4,梯度裁剪 1.0;说话人向量取 64 个训练片段声纹的平均(比单条参考录音稳),写进 codec_embedding 的第 3000 行;检查点按 bf16 保存,tts_model_type 改成 custom_voice,spk_id 只有这一个人。
训练数据用的是不带语言标签的前缀(nothink),所以生成时语言要用 auto,指定 chinese 会切到模型没见过的前缀。Base 模型从没学过指令,微调出来的声音不支持语气描述。
内存:第一次跑进了交换
全量训练 1.6B 参数(文字嵌入层也训练)时占 44GB,第 2 轮存检查点时额外复制一份权重,系统开始用交换内存,每步从 1.2 秒变成 15 秒。改了 3 处:
- 冻结文字嵌入层:3.11 亿参数、15 万个词元,18 分钟录音只用得到几百个。省约 4GB,也少一点过拟合(细节见下一节)。
- 存检查点时逐个张量先搬到 CPU 再转 bf16,存完
torch.mps.empty_cache()。 - 冻结的参数改存 bf16(不更新,不需要 fp32)。
之后 1.7B 全量稳定在 37–41GB,每步 1.2 秒。
冻结文字嵌入层,有没有隐患
冻结不是去掉这一层:它照常参与计算,只是训练时不更新,保持 Base 模型原来的值。
它管什么。 talker.model.text_embedding 是一张 151936 × 2048 的查找表,每个词元一行,只回答“这是哪个字”。后面决定“这个人怎么念”的部分都在训练:
| 部分 | 形状 / 规模 | 训练时 |
|---|---|---|
text_embedding(认字) |
151936 × 2048,3.11 亿参数 | 冻结 |
text_projection(把文字向量翻译给说话模型) |
两层 2048 × 2048 | 训练 |
| talker 28 层(怎么念、语调、节奏) | 约 14 亿参数 | 训练 |
codec_embedding(声音编码、说话人向量所在) |
3072 × 2048 | 训练 |
| code predictor(每帧后 15 层声音编码) | 约 1.7 亿参数 | 训练 |
| speaker encoder(只用来算说话人向量) | – | 冻结 |
为什么数据少时冻结反而更稳。 不冻结的话,嵌入层每步只有训练文本里出现过的那几百行拿到梯度(AdamW 对梯度为 0 的行几乎不动),训练完“见过的字”和“没见过的字”在模型眼里慢慢变得不一致:换一句新话,可能有的字像他、有的字不像。冻结后 15 万个词元保持原样、彼此一致。
精度没有损失。 Base 模型发布的权重本来就是 bf16(text_embedding 和 text_projection 都是),冻结部分用 bf16 存,和原始权重逐位相同;保存检查点时本来也存 bf16。
真正的局限。 冻结的嵌入层不能给一个词“换身份”。如果某个词他的读法很特别(产品名的固定念法、方言里某个字的读音),只能靠后面 28 层按上下文去学;多数情况够用,但如果训练后某个词还是固定念错:
- 先在稿子里换写法:同音字、拆开、加空格,最省事;
- 数据多了(一两个小时)再训练时加
--train_text_embedding,多占约 4GB。新语言、新方言也属于这种情况。
证据的边界。 支持“认字没受损”的:微调后所有版本在训练集外的句子上错字率都低于 1%,包括 AI Agent、RPA 这类英文词,相似度也正常提升。没做过的:冻结和不冻结的严格对照。两个上线的音色都是冻结后训练的,不冻结的版本只跑过 1 轮(内存爆了),所以“两者效果一样”没有直接数据。要确认的话:同一份数据、batch 1 打开文字嵌入层训练 6 轮,对比相似度、错字率,再专门听几个专有名词。
怎么判断像不像
- Qwen 自带的声纹编码器不能用来评估:零样本复刻和参考录音的相似度 0.991,可另一个男声也有 0.974。8bit 和 bf16 的复刻都是 0.991(我听也没区别,所以线上留 8bit)。
- 用 CAM++,比对本人 40 个真实片段的平均声纹,不是单条参考录音。
- 训练集外的 5 句话 × 2 个随机种子,每个版本 10 条样音;另外看转写错字率和语速(真人约 5 字/秒,语速明显变快就是错位问题)。
- 分数是和训练录音比的,录音环境(麦克风、房间)也可能被学进去,最后靠耳朵挑。对比页把同一句话的各个版本放在一起。
结果
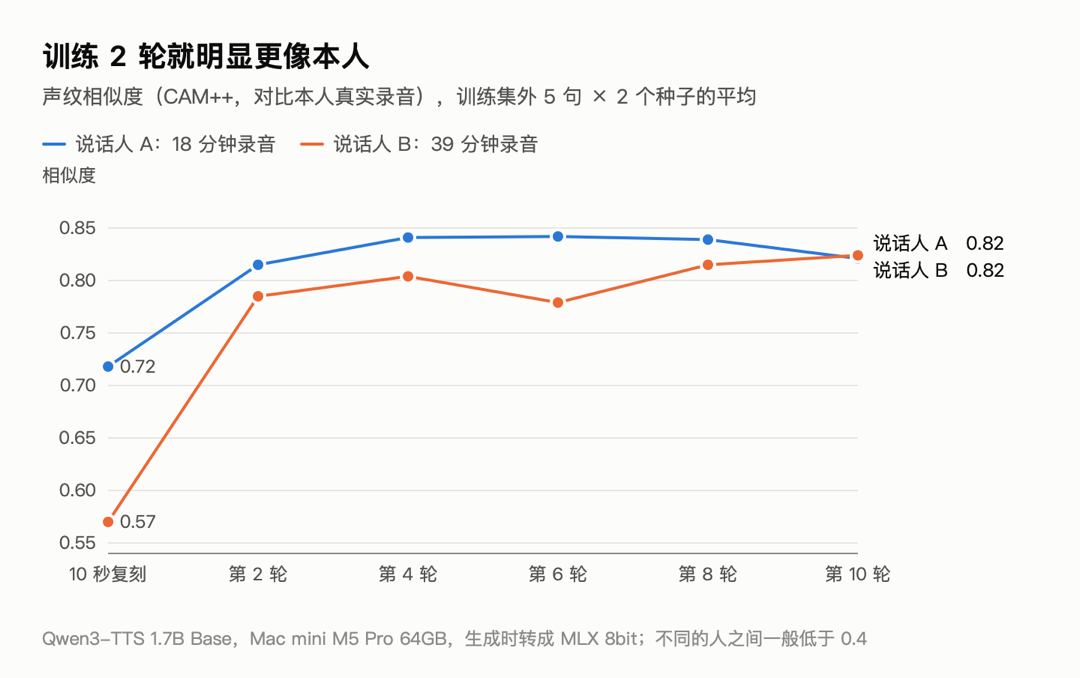
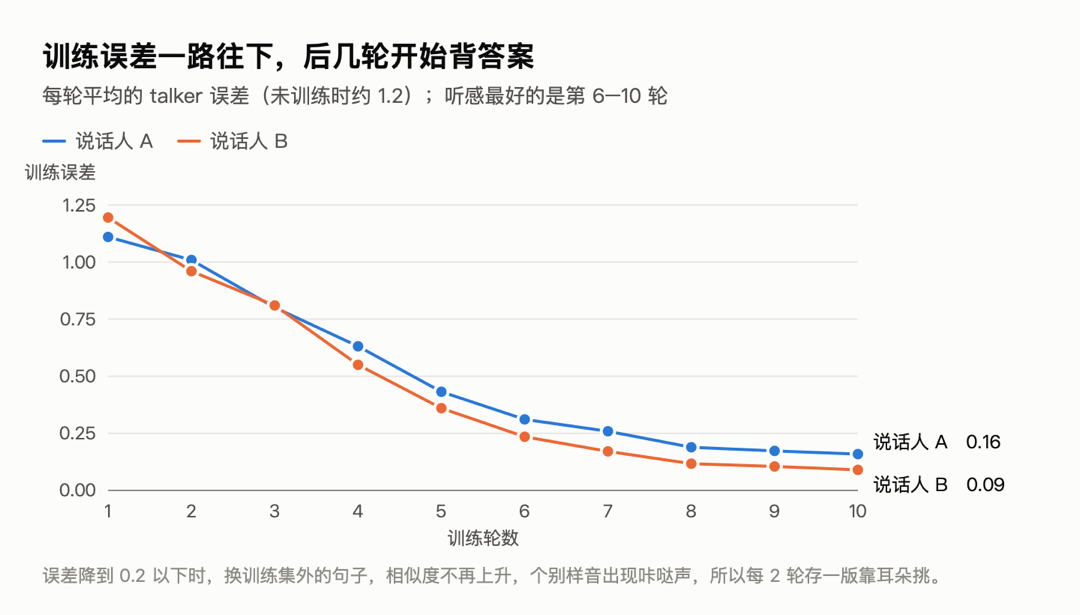
- 训练 2 轮就有大部分提升;之后基本持平。
- 训练误差到第 10 轮降到 0.1–0.2,开始背答案:A 的第 10 轮分数回落,个别样音有一声咔哒。所以每 2 轮存一版。
- A 的第 8、10 轮又各加测 8 句 × 3 个种子:0.815 对 0.827,打平。最后都是我听种子 11 那一组挑的:A 用第 8 轮,B 用第 10 轮,另一轮留作备用。
低内存方案
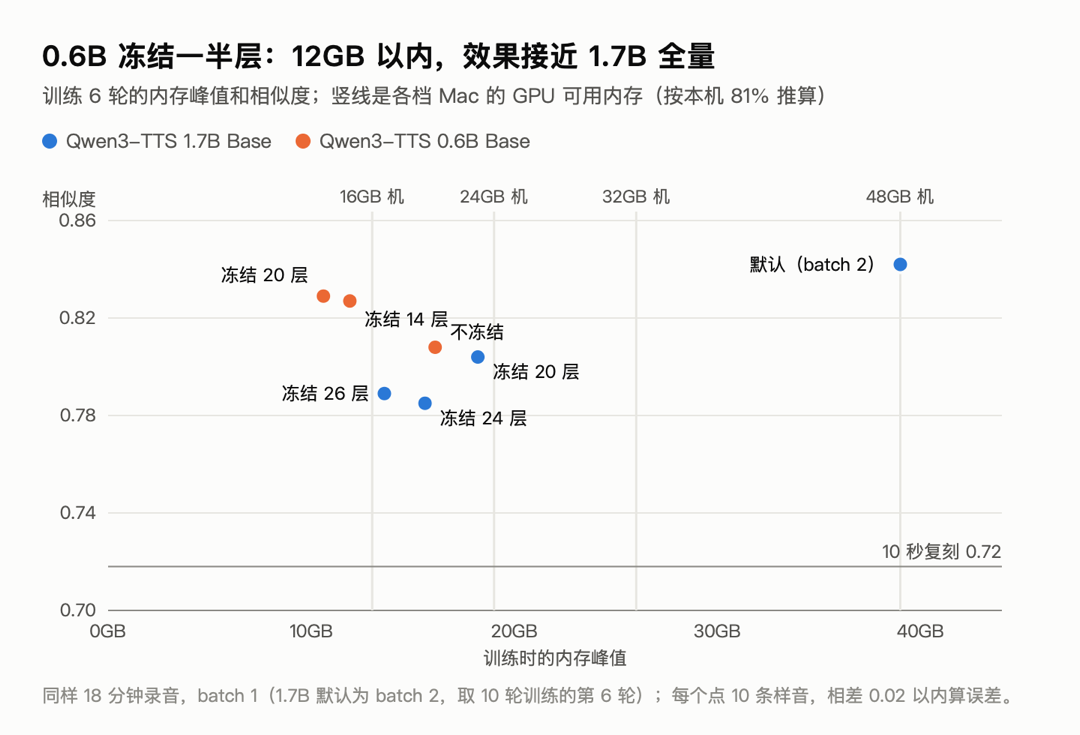
训练 6 轮效果就够用了。同样 A 的 18 分钟录音,batch 1 × 累积 8,在 64GB 机器上实测:
| 模型 · 设置 | 峰值 | 用时 | 相似度 |
|---|---|---|---|
| 1.7B 默认(batch 2,10 轮训练的第 6 轮) | 约 39GB | 约 10 分钟 | 0.842 |
| 1.7B 冻结 20 层 | 18.2GB | 7 分钟 | 0.804 |
| 1.7B 冻结 24 层 | 15.6GB | 6 分钟 | 0.785 |
| 1.7B 冻结 26 层 | 13.6GB | 5.5 分钟 | 0.789 |
| 0.6B 不冻结 | 16.1GB | 7 分钟 | 0.808 |
| 0.6B 冻结 14 层 | 11.9GB | 5 分钟 | 0.827 |
| 0.6B 冻结 20 层 | 10.6GB | 5 分钟 | 0.829 |
只改 batch 1 几乎不省(35.6 → 33.3GB),内存大头是被训练参数的权重、梯度和 Adam 状态(fp32 每参数 16 字节)。
macOS 不会把全部内存给 GPU:这台 torch.mps.recommended_max_memory() 是 51.8GB(81%)。按同比例推算(偏乐观,小机器比例可能更低,芯片也更慢;都没实测):
| 机器 | GPU 约可用 | 推荐 | 还剩 |
|---|---|---|---|
| 64GB | 52GB | 1.7B 默认 | 约 13GB |
| 48GB | 39GB | 1.7B 冻结 20 层(默认正好贴着上限) | 约 21GB |
| 32GB | 26GB | 1.7B 冻结 20 层 | 约 8GB |
| 24GB | 19GB | 0.6B 冻结 14 层 | 约 7GB |
| 16GB | 13GB | 0.6B 冻结 20 层 | 约 2GB |
0.6B 冻结一部分层,分数反而比 0.6B 全量高一点;每组只有 10 条样音,±0.02 以内算误差,0.6B 也还没用耳朵对比过。
部署
1
2
# 选好的一轮转成 MLX 8bit,放进模型目录
python -m mlx_audio.convert --hf-path <ckpt>/epoch-8 --mlx-path ~/Models/qwen3-tts/tuned/<id>-e8-8bit -q --q-bits 8
~/.config/ttsd/config.json:
1
2
3
"tuned_voices": {
  "<id>": {"name": "显示名·微调", "model": "tuned/<id>-e8-8bit", "speaker": "<id>", "gender": "m", "lang": "zh"}
}
speaker 必须和训练时的 --speaker_name 一致。改完 launchctl kickstart -k gui/$(id -u)/<label> 重启,再用 API 建一个临时稿件生成一句验证,删掉稿件。
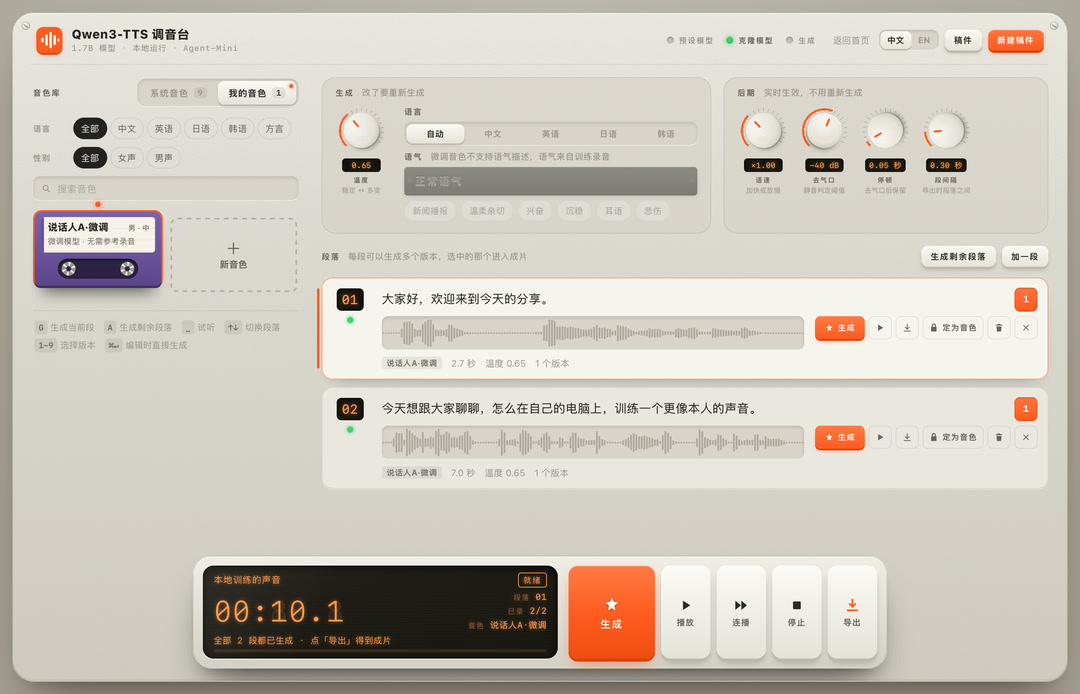
ttsd 的改动:音色 id 是 tuned:<id>,每个微调音色单独占一个模型槽;生成时语言固定 auto、不传语气;网页里归到“我的音色”,选中时语气框变灰。
踩坑记录
- Safari 点播放没声音、下载正常:网页用 Web Audio 播放,服务端和代码都没问题,重启 Safari 就好了。播放失败目前不提示,以后可以加一个报错。
- ttsd 的
safe_id只认十六进制:微调音色 id(如英文名)会被判无效,音色不出现。改成“必须是配置里已有的 key”,新加的单元测试抓到的。 - 说话人 key 要用英文:它会变成模型里的 speaker id 和目录名。开源版强制 ASCII。
- HF 下载卡在最后一步:文件已经下完(大小对得上),卡在校验改名。临时文件名里就是 sha256,自己算一遍对上了再
mv到位。 pkill -f误杀:杀下载进程时的匹配串,也出现在另一个等待下载的后台命令里,把它一起杀了。按 PID 杀更稳。- zsh 不按空格拆变量:
set -- $var在 zsh 里不拆分,循环参数要写开或用数组。 - mlx-audio 会读
sys.argv:自己的脚本用命令行传模型路径,被它当成了模型名。改成写在脚本里。 - MPS 上声纹编码器的 dtype:模型是 bf16 时,mel 输入要转成同样的 dtype。
- 截图脱敏:截图前在页面里用 JS 改名、删掉真人内容;复核页用系统音色合成的演示数据重跑一遍再截。Playwright 渲染图表时,
font-family里的双引号会截断 HTML 的style="…",字体就变回默认衬线体。
复现
最短路径(2026-10-29 加的 run.sh / deploy.py,视频文件可以直接放进素材文件夹,非 wav 的用 ffmpeg 解码):
1
2
3
4
5
cd finetune && cp voiceprep.example.json voiceprep.json   # 填好后
./run.sh prep                 # 切片 + 转写 + 筛人,完成后打开复核页
./run.sh train alice          # 编码 → 训练 → 样音 → 打分;小内存加 --epochs 6 --batch_size 1 --grad_accum 8 --freeze_layers 20
./run.sh review               # /compare/alice 挑一轮
./run.sh deploy alice 8 --name "显示名" --gender m --restart <ttsd 的 launchd label>
deploy 会把模型复制进控制台的 models_dir/tuned/,备份后改 tuned_voices(speaker id 从检查点里读),可选重启。逐步手动跑:
1
2
3
4
5
6
7
8
9
10
cd finetune
cp voiceprep.example.json voiceprep.json      # 说话人、参考录音和文字稿、素材目录
.venv/bin/python prep_data.py
.venv/bin/python review.py                    # 127.0.0.1:18410,无登录,只在本机开;远程用 ssh -L
.venv-train/bin/python build_train.py alice
.venv-train/bin/python sft.py --train_jsonl <work>/alice/train_with_codes.jsonl --speaker_name alice \
    --output_dir <work>/alice/ckpt --epochs 10 --save_epochs 2,4,6,8,10
#   小内存:--batch_size 1 --grad_accum 8 --freeze_layers 20 [--init_model_path Qwen/Qwen3-TTS-12Hz-0.6B-Base]
../.venv/bin/python gen_samples.py alice
.venv/bin/python score_samples.py alice       # 然后打开 /compare/alice 听
还没验证的
- 16GB / 24GB / 32GB 机器上的真实内存和速度(都是按 64GB 的峰值和 81% 推算的)。
- 0.6B 微调版的听感;网页目前默认按 1.7B 的预设/克隆模型加载,0.6B 微调版能转换、能生成,但没上线。
- 更多数据(几小时)能不能继续提高;10 秒以内的片段占比对口音的影响。